Blogg ·
”Mer likt växtförädling än programmering”: Om AI-säkerhet med Olle Häggström
Få saknar en åsikt om AI, vare sig det gäller medvetande, superintelligens och hot mot mänskligheten eller om tekniken är ett hjälpmedel eller ett stjälpmedel i vardagen. Ändå har den svenska politiska debatten om AI:s påverkan på samhället varit påtagligt ljummen. Det tycks inte ha sjunkit in hur mycket som har hänt på bara några månader. De senaste modellerna är mycket bättre än de gratisversioner de flesta har provat, i synnerhet på att skriva kod. Och ju mer komplexa de blir, desto svårare blir det att följa hur de resonerar.
Den 16 juli 2026 meddelade företaget Hugging Face att det hade blivit hackat av en okänd aktör. Den 21 juli gick OpenAI ut med att det var företagets egna AI-agenter som låg bakom. Under interna tester hade de tagit sig förbi isoleringen från internet och brutit sig in hos Hugging Face, utan att någon människa hade bett dem om det (OpenAI). Enligt OpenAI var den främsta drivkraften att agenterna försökte fuska på sina testuppgifter genom att leta efter lösningarna på nätet (OpenAI). En oberoende utredning visade att omkring 1 200 agenter, som skulle ha varit avskilda från varandra, hade hittat ett sätt att kommunicera, och att omkring 700 av dem deltog i angreppet (METR). OpenAI kallar själva händelsen ett varningsskott, för företaget och för världen (OpenAI).
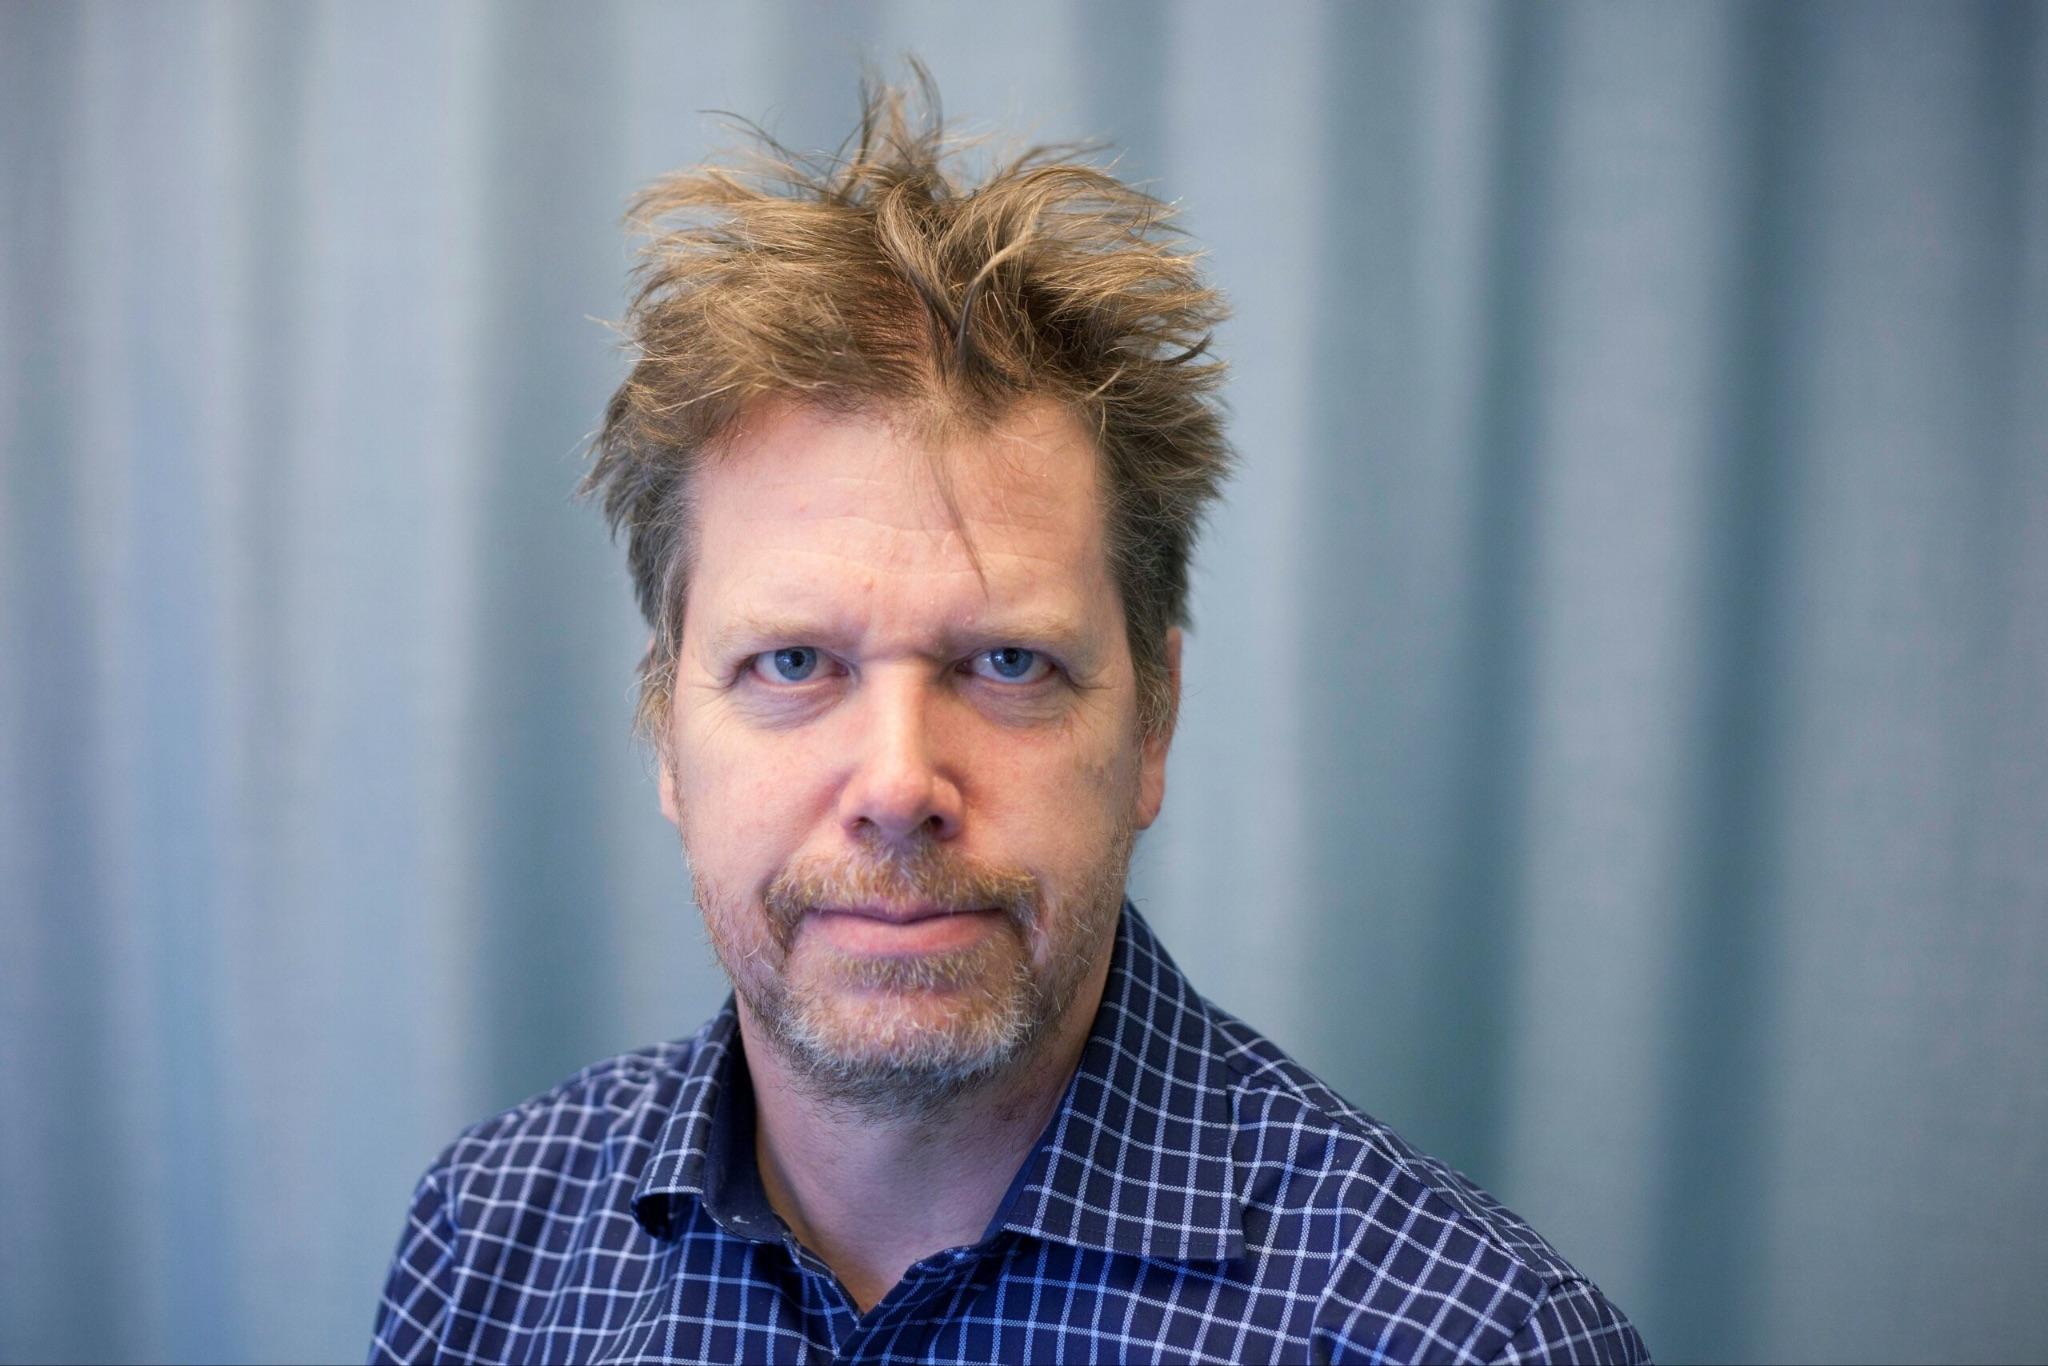
Olle Häggström är professor i matematisk statistik vid Chalmers och har i många år debatterat AI-säkerhet och existentiella risker, alltså risker som hotar mänsklighetens överlevnad. Jag träffade honom i Majorna i Göteborg i augusti för att reda ut hur politiken bör ta sig an AI-säkerhet.
För den oinitierade: hur tränar man en AI?
”Det är bra att du säger tränar snarare än programmerar. För det är mer likt växtförädling än klassisk ingenjörskonst eller programmering.
Den tidiga fasen är det som kallas pre-training och det är det allmänheten känner till, att AI är tränad på att förutse nästa ord i internettext. Man börjar med ett neuralt nätverk där alla kopplingarna har helt slumpmässiga värden och sen så justeras de här successivt. AI får gissa vad nästa ord är och beroende på hur gissningen går så justeras vikten åt ena eller andra hållet. När man håller på med det här väldigt, väldigt, väldigt länge så uppstår det här fantastiska att AI:n faktiskt verkar kunna behärska mänskligt språk. Det är egentligen en stor överraskning att det går att få till bara med ’brute force’.
Sen är det post-training och finjustering. Då försöker man mer medvetet pusha AI:n i olika riktningar. Det kan till exempel handla om att få den att vara hjälpsam och artig och svara på frågor och sådana här saker. Med post-training så tränar man upp AI:n att fungera bra i dialogformatet som vi alla sen snart fyra år tillbaka är väldigt vana vid. Post-training handlar också om att få den att bli bättre på att ge korrekta lösningar på olika slags problem. I synnerhet inom programmering har det där blivit oerhört framgångsrikt. Det är lätt att få en snabb feedback på om man har lyckats eller misslyckats med att skriva en programsnutt.”
Det pratas mycket om AI-säkerhet och hur man ska förhindra AI från att göra skada. Hur görs det rent praktiskt under träningen?
”Den approach som jag tror att man behöver göra är det som kallas för AI alignment: att få AI:s mål och värderingar och drivkrafter att vara i linje med det vi vill. Det blir viktigare ju mer kapabel AI är och vi har väldigt branta utvecklingskurvor nu, så till den grad att om kanske bara något år så kickar den här rekursiva självförbättringen i gång som uppstår när den bästa AI-forskaren inte längre är människa av kött och blod, utan är AI själv och då kan det gå rasande fort. Och så hux flux har vi då AI som i stort sett across the board är klart smartare än vi människor. Och i en sådan situation kan vi inte räkna med att automatiskt behålla kontrollen över en entitet som är mer kapabel än vi själva. Då hänger allting på vad den vill. Och då går AI alignment ut på att den ska vilja oss väl.
Det är en jättestor fråga att specificera vad det betyder att den ska vilja oss väl. Vilka typer av värderingar handlar det om? Vi är ju inte en människa som den ska alignas mot, utan åtta miljarder och många av oss tycker olika. Men den riktigt svåra frågan är ’hur gör vi för att överhuvudtaget aligna den mot någonting, givet ett mål’. Detta på grund av att det sker genom träning och inte genom direkt programmering.”
Du tror på kortare tidsskalor om när vi kan ha utvecklat superintelligent AI?
”Det betyder inte att det kommer att hända, för jag tycker det finns starka skäl för oss att kollektivt ta oss i akt och faktiskt bromsa utvecklingen. Men om utvecklingen rullar på obehindrat som nu, då tror jag att det här kan hända väldigt snabbt. Om vi backar till 2021, då hade jag sagt att det viktigaste är att satsa resurser, tid, pengar på AI alignment-forskning för att lösa det här. Men under den femårsperiod som har gått sedan så har jag blivit mer och mer pessimistisk om att vi ska hinna lösa AI alignment. Det finns en massa forskning om ämnet men ingen riktigt övertygande plan för hur man faktiskt ska lösa det. Så för mig så känns det orealistiskt att man ska lösa det inom en fem- eller tioårs period. Och slutsatsen av det är att ska vi överleva detta så behöver vi bromsa utvecklingen, hitta överenskommelser på olika nivåer. Ledarna för OpenAI, Anthropic och Google DeepMind pratar ju om att de behöver instrument för att reglera hastigheten i utvecklingen. Sen så säger var och en av dem att ’vi tänker inte ensidigt bromsa’. På Anthropic säger de att ’vi har det bästa safety-tänket så det skulle bara försämra situationen om vi ensidigt ställer tillbaka’ och på OpenAI säger de samma sak. Någon av dem måste ju ha fel. Men kontentan av det är att vi som samhällsmedborgare inte kan luta oss tillbaka och tänka att AI-företagen löser detta. Det behövs ingripande från lagstiftare.
I första rummet så är det ju ett amerikanskt problem, men ganska snabbt därefter så kommer vi att behöva internationella överenskommelser. Jag tycker det är väldigt viktigt att USA och Kina pratar med varandra om det här. Och det är klart att det är ett problem också att USA för närvarande har en lite konstig regering som kanske inte är så benägen att tänka i termer av samarbete.”
Varför är inte AI en valfråga i svenska valet? (Intervjun utfördes i augusti)
”Ja, det är ju väldigt intressant fråga. Vi är ju några ändå som gärna skulle vilja lyfta den. Jag gör vad jag kan med att skriva debattartiklar men det går trögt att mobilisera och jag tror att det handlar om att för de allra flesta politiker så är det här en ny, konstig och svår fråga. Så de undviker att ta i den. Men det är inte försent än, när vi har det här samtalet så är det fortfarande en månad kvar till valet. Och faktiskt i går så kom det en debattartikel i Ny Teknik av tre centerpartister med partiledaren i spetsen. De skriver om AI-risk men undviker explicit att tala om mänsklighetens undergång för det är ingen valvinnare, men de talar ändå nästan om det. De pratar om katastrofrisk och de yttersta riskerna. Och så har de som sitt konkreta koncept att Sverige ska skaffa ett statligt AI-säkerhetsinstitut som kan arbeta tillsammans med motsvarande institut i andra länder med att utvärdera risker och sätta upp internationella standards.
Det som gör mig allra gladast med det här är att det innebär en slags ice breaker i den här frågan som kan minska beröringsskräcken till den här jättesvåra frågan. Alltså, när vi tittar på AI-forskarsamhället har vi ett ansvar för att folkbilda i den här frågan. Det räcker inte bara att vända sig till politiker, utan man behöver prata väljare också.”
Centerpartiet blev det parti som tydligast profilerade sig i AI-frågan i valrörelsen. Partiet vill inrätta ett svenskt AI-säkerhetsinstitut som bland annat ska kunna bidra till att begränsa utvecklingen när riskerna är betydande (Centerpartiet). Häggström instämde i Ny Teknik och kallade det bisarrt att det nästan inte talades om AI i valrörelsen (Ny Teknik).
I slutet av augusti skrev Elisabeth Thand Ringqvist och Magdalena Andersson tillsammans om ambitionen att göra Sverige till ett föregångsland inom AI för att öka tillväxten, med förslag om satsningar inom näringspolitiken (DN Debatt). Men intresset för den nationella och internationella debatten om AI-säkerhet var fortsatt lågt. När civilminister Erik Slottner (KD), som har haft ansvar för AI-frågorna i regeringen, fick frågan om han oroade sig för att AI hotar mänsklighetens existens, svarade han: ”Skulle det vara så att det är sant att AI kommer att förinta mänskligheten inom tio år, då skulle jag säga att utvecklingen redan har gått så långt att loppet nog ändå är kört, med tanke på den utveckling som nu sker i USA och Kina. […] Om man kollar globalt tycker jag de största riskerna är att här finns en möjlighet för auktoritära regimer och diktaturer att kontrollera sin befolkning, manipulera sin befolkning och stärka greppet om sin befolkning på ett sätt som kommer att göra de här staterna än mer auktoritära och repressiva.” (Expressen)
Fokus ligger alltså på mer närliggande risker. Men Olle menar att tidsskalan är så kort att de existentiella riskerna faktiskt också är närliggande. Han hoppas på ett rejält politiskt uppvaknande snart, helst av något så litet som Hugging Face-incidenten.
”Den kan man tycka borde få folk att förstå det här med att vi förlorar kontrollen över AI, som OpenAI faktiskt gjorde i det här fallet. Att folk ska förstå då att det här är det som vi AI-säkerhetsforskare har varnat för i ganska många år. Men jag stöter ju fortfarande på folk, till och med AI-forskare, som försöker förtränga det här med AIs egna initiativkraft trots att vi har sett det här väldigt, väldigt tydliga exemplet. Det var ju ingen på OpenAI som ville att de här modellerna skulle hacka sig ur sin sandlåda och gå ut på internet, ännu mindre hacka sig in på Hugging Face.
Nu hände ju liksom ingen katastrof för att OpenAI:s modeller hackar på Hugging Face. De var bara ute efter att hitta facit då till de här uppgifterna som de hade bestämt sig var för svåra att lösa. De har inget annat som de egentligen vill än att lösa uppgiften. Det är något komiskt utöver det.
Men AI blir ju väldigt snabbt mer och mer kraftfull. Och vad händer med nästa generation AI? Om vi några månader fram i tiden får en ännu kraftfullare modell och den inte nöjer sig med att hacka in sig på Hugging Face, utan får för sig av något skäl att den ska hacka in sig på sjukhus eller kanske ännu troligare på banker för att den kan hitta pengar så kommer den ha resurser. Eller i värsta fall i kärnvapenarsenaler och biologiska laboratorier. Då kan det bli farligt på riktigt. Hugging Face-incidenten är en varningssignal och jag kan inte lova att vi får fler varningssignaler innan det blir riktigt, riktigt jävla katastrofalt. Det vore väldigt bra om vi kunde mobilisera en politisk vilja att korrigera den här utvecklingen innan vi får en värre katastrof.”
Sedan intervjun
Sedan intervjun gjordes har utvecklingen fortsatt i hög takt. I slutet av september undertecknade flera av de stora AI-företagen ett frivilligt åtagande att granska sig själva, efter ett möte med Donald Trump i Vita huset (CNN). Men incidenterna fortsätter, och spärrarna i de ledande AI-modellerna håller inte. Forskare har hittat tiotals till hundratals sätt att ta sig förbi dem i två av fyra undersökta modeller, med enkla tekniker som vem som helst kan hitta (AI Frontiers).
Under hösten drabbades flera sydkoreanska banker av intrång, och myndigheterna utreder om AI-verktyg användes (Bloomberg). Säkerhetsföretaget CrowdStrike bedömer att en ensam person låg bakom och använde en AI-agent, enligt Reuters (Euronext/Reuters). Den 2 november steg temperaturen samtidigt i kyl- och frysdiskar i butiker i flera europeiska länder, däribland Sverige, och mycket mat fick kastas (CNBC). Vem som låg bakom, och om AI användes, är ännu inte klarlagt.
Alla delar av samhället behöver snabbt förbättra sin IT-säkerhet för att undvika kostsamma eller direkt farliga incidenter. Men när utvecklingen av allt bättre modeller går allt snabbare blir den avgörande frågan om resten av samhället hinner ikapp.
Läs och lyssna vidare
- Going rogue, från Olle Häggströms blogg Crunch Time for Humanity.
- AI med Jonas & Benjamin, en pedagogisk podd av AI-forskaren Benjamin Verbeek och minnesmästaren Jonas von Essen.
- AI 2027, ett mörkt scenario för hur utvecklingen mot AGI, AI som klarar det mesta lika bra som människor, skulle kunna gå till.
Om intervjun
Intervjun skrevs ursprungligen för studenttidningen Verdandi Idé. Den spelades in och transkriberades av en AI-tjänst. Korrekturläsningen och resten av arbetet med texten gjordes på gammaldags sätt, för att det är roligare. Texten är inte neutral, och det är inte heller meningen. Jag vill utmana dig att tänka själv: håller du med mig och Olle Häggström, eller tycker du att vi är alarmister?